
在 Archive.org 书籍页中解析 BookReader 页面,批量下载图片或生成 PDF。
📖 简介
═══════════════════════════════════════
Archive.org 书籍下载器是一个专为 Archive.org 图书馆设计的浏览器扩展。
它可以自动解析书籍页面,批量下载高质量图片,并将其转换为 PDF、ZIP 或 CBZ 格式,方便离线阅读和收藏。
═══════════════════════════════════════
✨ 功能特性
═══════════════════════════════════════
🚀 自动解析 —— 一键解析 Archive.org 书籍页面,自动获取所有页面信息。
📥 批量下载 —— 支持批量下载书籍图片,自动转换为 JPEG 格式(质量 1.0,最高质量)。
🔐 图片解密 —— 自动处理 Archive.org 的图片混淆 / 加密。
💾 本地存储 —— 使用 IndexedDB 存储图片,支持断点续传。
📄 多格式导出 —— 支持导出为 PDF、ZIP 或 CBZ 格式。
🎯 选择性下载 —— 可以选择特定页面进行下载或导出。
🖼️ 图片预览 —— 支持下载前预览图片。
🔄 拖拽排序 —— 支持拖拽调整页面顺序。
🌍 多语言支持 —— 自动适配浏览器语言(中文 / 英文)。
🎨 手动捕获模式 —— 逐页翻页捕获,适用于需要精确控制的场景。
═══════════════════════════════════════
🚀 使用方法
═══════════════════════════════════════
📌 使用前提(请务必先阅读)
───────────────────────────────────────
在开始之前,请务必确认以下三点,否则可能导致解析失败或下载中断:
1. 🔌 保持插件弹窗处于激活状态
• 整个解析、下载、生成 PDF / ZIP / CBZ 的过程,必须保持扩展弹窗处于打开状态。
• Chrome 扩展弹窗属于系统级浮层,点击浏览器页面或切换到其他窗口时,弹窗会自动关闭。
• 一旦弹窗关闭,正在进行的下载与解析会立即中断。
• 已下载的图片会保存在本地 IndexedDB 中(不会丢失),下次重新点击扩展图标,可从断点处继续下载。
• 建议:解析期间不要点击页面其他区域、不要切换窗口,耐心等待进度完成。
2. 🔑 借阅书籍(针对受限内容)
• 如果目标书籍标注为 Borrow 或者 Log In And Borrow,则需先借阅,才能正常下载完整内容:
1) 使用 Archive.org 账号登录;如无账号,请先在以下地址免费注册:https://archive.org/account/signup
2) 在书籍详情页点击 Borrow 按钮,完成借阅。
3) 等待 BookReader 阅读器加载出完整书籍内容(可正常翻页阅读)。
4) 此时再点击扩展图标,使用本插件进行解析下载。
• 注意:未借阅时强行解析,往往只能获取到封面或预览页,且图片可能被加密无法解密。
3. 📖 确保 BookReader 已完全加载
• 进入书籍详情页后,请等待页面中的 BookReader 阅读器完全加载完成(能够正常翻页)。
• 再点击扩展图标启动解析,避免因页面未就绪导致页面信息提取失败。
───────────────────────────────────────
方法一:自动解析(推荐)
───────────────────────────────────────
1. 打开书籍页面
• 访问 Archive.org 书籍详情页,例如:https://archive.org/details/isbn_9780440842897
2. 启动解析
• 点击 Chrome 工具栏的扩展图标。
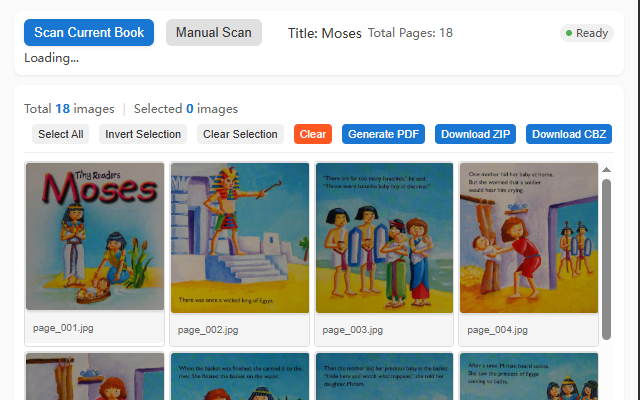
• 点击「解析当前书籍」按钮。
• 等待自动解析和下载完成。
3. 生成文件
• 解析完成后,选择需要的页面(或全选)。
• 点击「生成 PDF」、「下载 ZIP」或「下载 CBZ」按钮。
• 选择保存位置,完成下载。
───────────────────────────────────────
方法二:手动捕获模式
───────────────────────────────────────
⚠️ 重要提醒:使用手动捕获前,请务必:
1) 在 Archive.org 页面上切换到单页阅读模式(点击页面上的单页图标)。
2) 将书籍翻到第一页(起始页)。
3) 然后再点击「手动解析」按钮。
1. 准备阶段
• 访问 Archive.org 书籍详情页。
• 切换到单页阅读模式。
• 确保当前显示第一页。
2. 开始捕获
• 点击扩展图标。
• 点击「手动解析」按钮。
• 扩展将自动逐页翻页并捕获图片。
3. 完成下载
• 捕获完成后,按照方法一的步骤 3 生成文件。
───────────────────────────────────────
其他功能
───────────────────────────────────────
• 图片预览:点击任意图片可全屏预览。
• 选择页面:使用「全选」、「反选」、「清除选择」按钮。
• 删除图片:选中后点击「删除选中」。
• 拖拽排序:直接拖拽图片调整顺序。
• 清空数据:点击「清空」按钮清除所有本地数据。
═══════════════════════════════════════