AI 网页抓取 Chrome 扩展。 只需点击 2 次,即可使用 AI 抓取数据并将其提取到 Excel!
Clura Web Scraper 是一款能直接在 Chrome 浏览器中将网站内容转化为结构化数据的工具。
使用 Clura,您可以采集页面上的可见数据,在整洁的表格中进行查看,利用联系方式丰富数据行,从关联的详情页提取字段,设置定期采集任务,并将数据发送到团队现有的各类工具中。
⚡ Clura 的工作原理
1. 在 Chrome 中打开网页
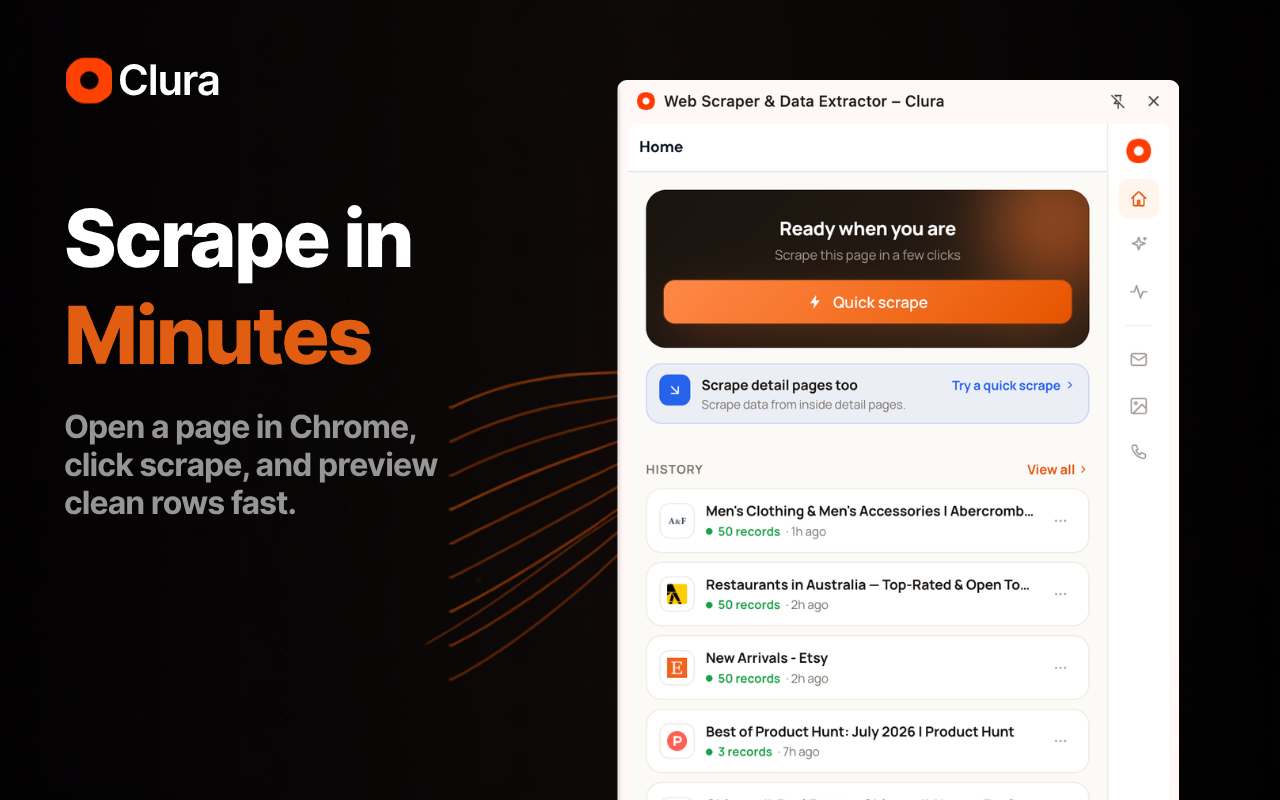
2. 运行“快速采集”(Quick Scrape)以识别页面上的重复记录
3. 检查提取出的行与列
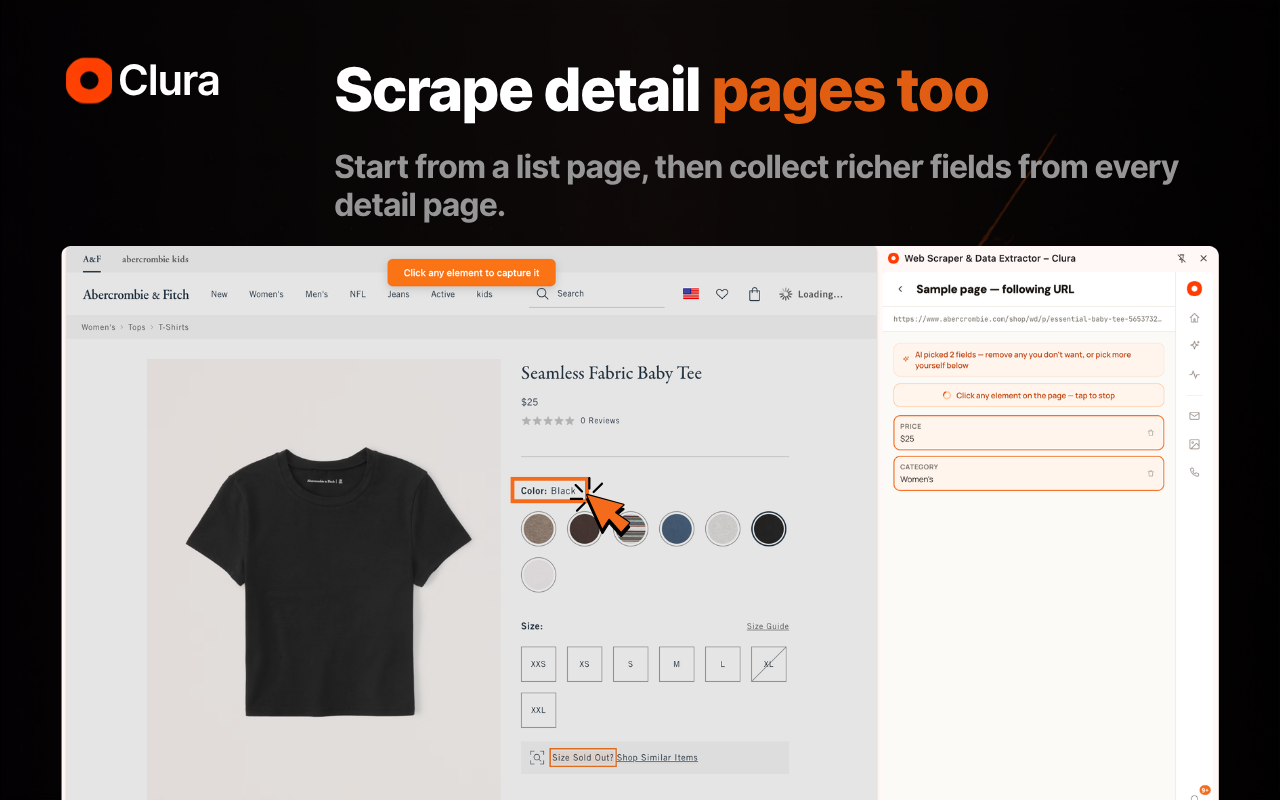
4. 根据需要添加来自关联详情页的字段
5. 采集详情页以丰富数据行内容
6. 导出为 CSV 或 Excel 格式
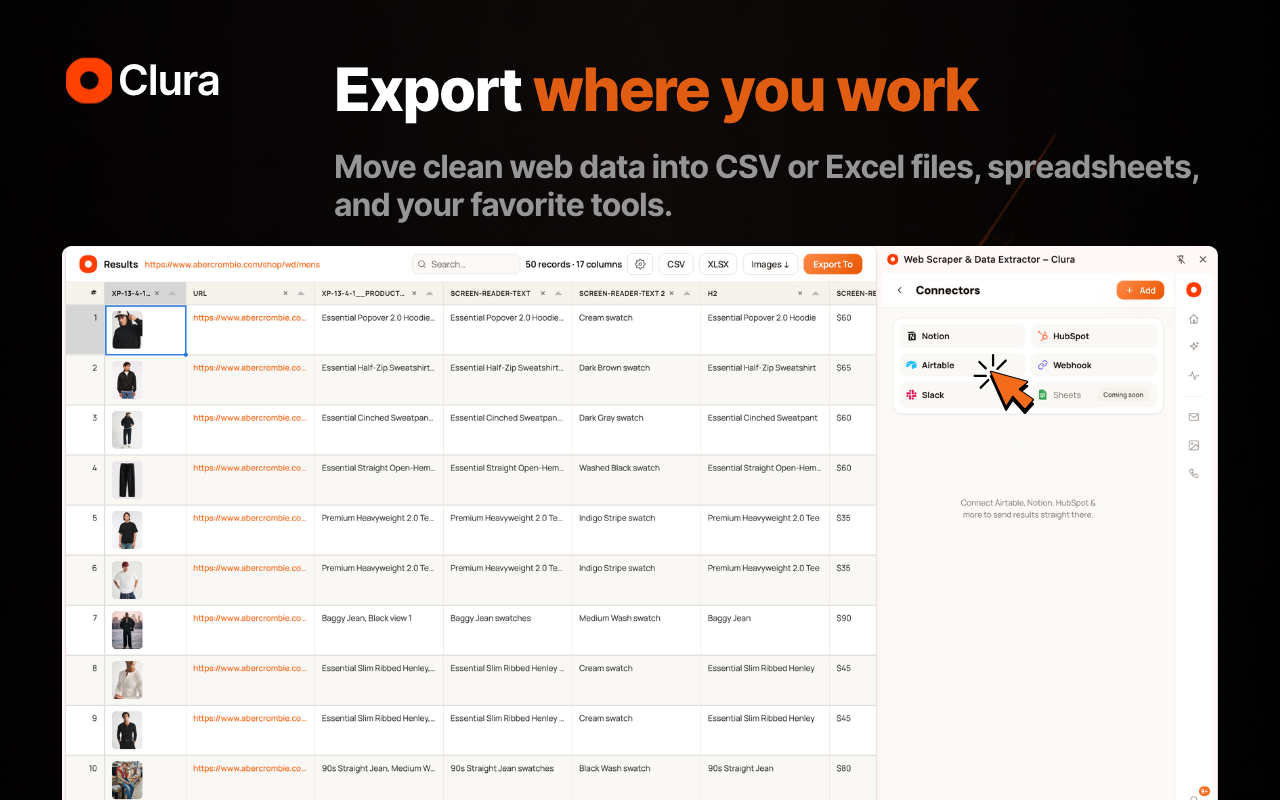
7. 将数据发送至 Notion、HubSpot、Airtable 或 Webhook
8. 使用“代理”(Agents)按计划重复采集或监控页面变化
✅ 核心功能
快速采集 (Quick Scrape)
将网页上的可见记录转化为结构化表格。该功能特别适用于布局重复的页面,如目录、列表、搜索结果、产品页、招聘页、个人资料页、表格及卡片式布局页面。
子页面采集 (Sub-page Scrape)
突破单页限制。采集列表后,Clura 可访问关联的详情页,并将选定字段添加回原始表格中。当关键信息位于公司简介、产品页、职位描述、房产详情页或其他详细页面时,此功能尤为实用。
数据丰富 (Enrichment)
为采集到的数据行补充联系信息,包括电子邮件、电话号码和 LinkedIn 链接。团队可利用此功能构建基于可靠来源的潜在客户名单、供应商名录、招聘名单、研究数据集及客户调研表。
代理 (Agents)
设定工作流按日、周或月定期运行。代理功能可帮助团队保持数据集更新、采集新记录,并持续监控页面变化。
连接器 (Connectors)
将采集并丰富后的数据发送至 Notion、HubSpot、Airtable 或通用 Webhook。新记录可直接追加到现有目标位置,从而减少手动上传 CSV 文件及后续清理工作。
🎯 常见工作流
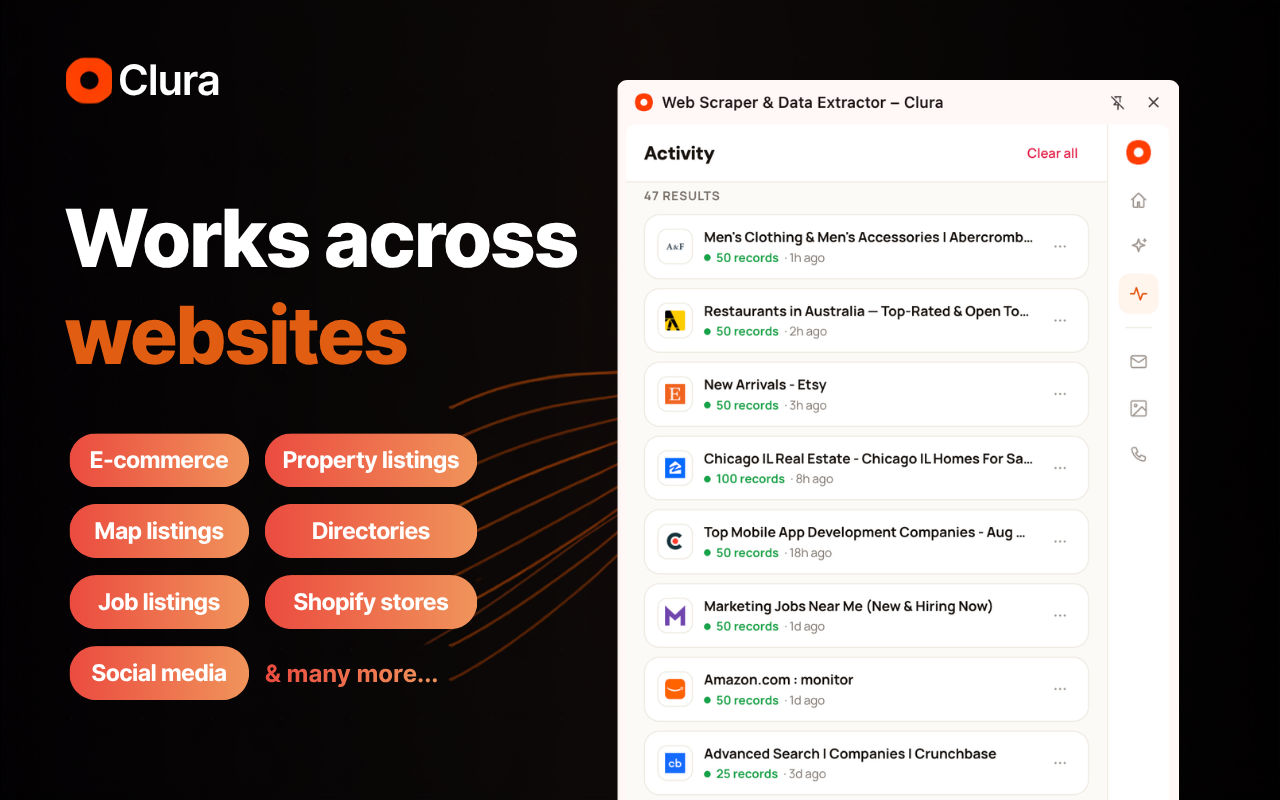
潜在客户开发与外联团队利用 Clura,从垂直领域目录、评论网站、协会页面、在线市场、本地商家名录及公司简介页构建定制化的潜在客户名单。
电商团队利用 Clura 采集产品名称、价格、评分、库存状态、卖家信息、产品链接及规格参数,用于市场调研、商品目录构建或竞品监控。招聘人员和销售团队利用 Clura 从公开招聘页面及招聘网站上采集职位发布信息、公司名称、职位角色、工作地点、发布日期及职位详情等数据。
房地产及本地市场研究团队利用 Clura 从房源或商家列表页面中采集房产/商家信息、地理位置、价格、评分、地址及联系方式等数据。
🔌 专为数据工作流打造
Clura 专为那些需要在电子表格或业务工具中使用网络数据,却又不想编写爬虫代码、维护选择器或在页面间手动复制记录的团队而设计。
当您需要将公开网站信息转化为结构化、可核查的数据,以支持销售、研究、招聘、运营、电商或报表制作等工作流时,Clura 便是您的理想之选。
🛡️ 负责任的使用
Clura 旨在提取您在 Chrome 浏览器中可访问页面上的可见数据。
请负责任地使用 Clura:
- 遵守网站的服务条款
- 请勿采集私密、受限或敏感数据
- 请勿将提取的数据用于发送垃圾信息或从事有害活动
- 在将导出数据用于销售、营销、招聘或研究工作流之前,请先进行核查
- 遵守适用的隐私、电子邮件及数据保护法律法规
Clura 助力团队无需编写代码,即可将公开网站信息转化为整洁、结构化的数据工作流。