
搜索互联网档案馆和网络档案、探索网站历史记录、比较旧页面并恢复已删除的内容。
Web Archive Viewer 允许您从浏览器查找任何网页的存档副本。 🌐
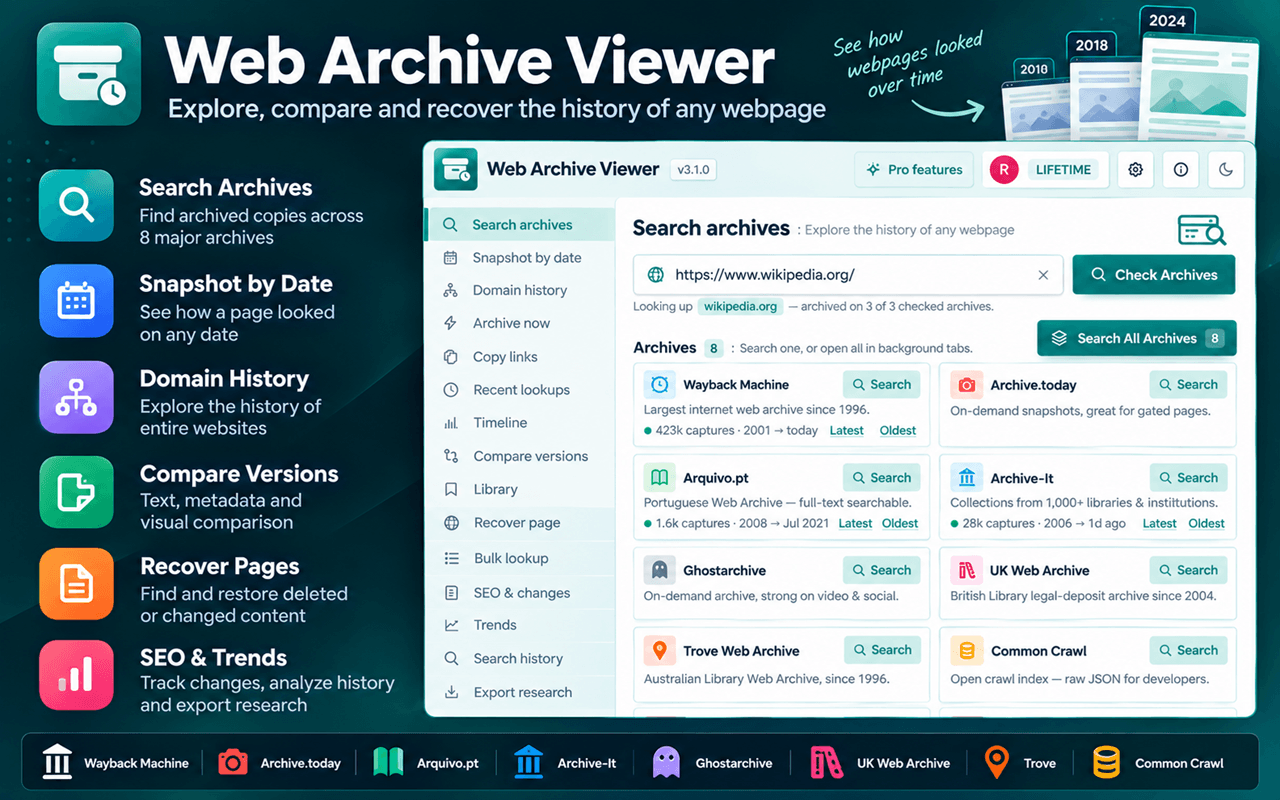
从一个扩展程序搜索互联网档案馆的 Wayback Machine 以及其他几个公共网络档案。一次检查单个存档或所有存档,查看捕获日期和计数,并一键打开快照。
🔎 搜索和网站历史记录:查找页面的旧版本并找到特定日期的捕获。
📅 按日期快照 — 查找任意日期最接近的存档版本。
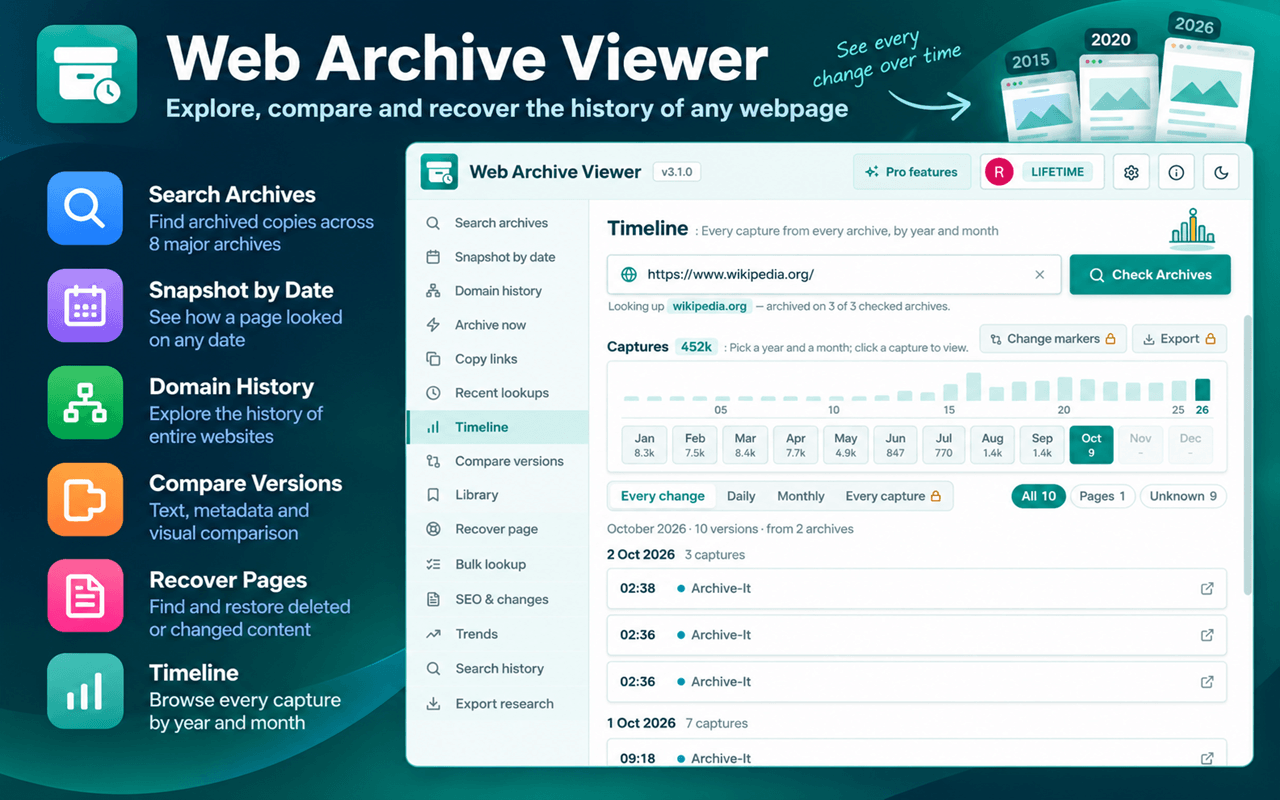
🕐 时间轴 — 按年、月、日探索捕获、识别更改、过滤捕获类型并导出结果。
🌐 域名历史记录 — 探索网站上的历史 URL、子域名、页面、文件、重定向和错误。
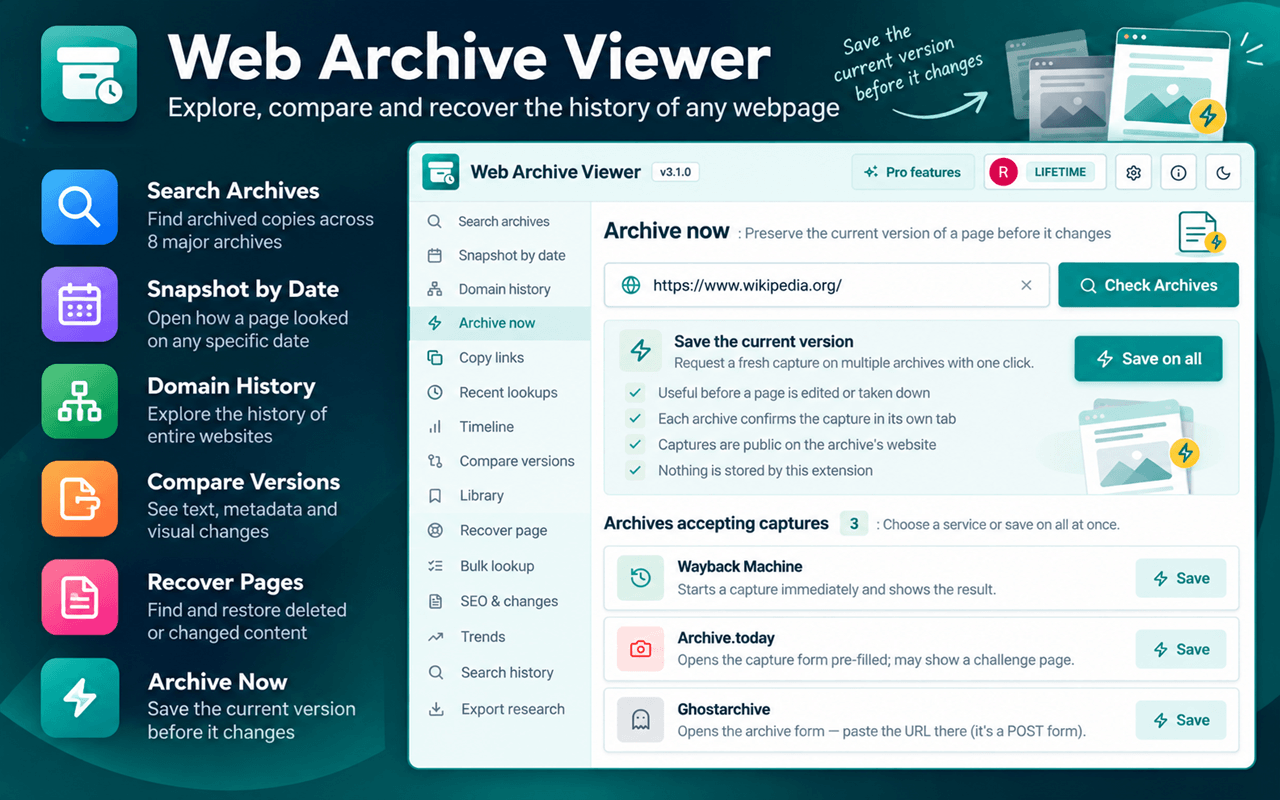
📸 立即存档 — 通过支持的存档服务请求新的捕获。
🔗 复制链接和最近查找 — 快速保存存档链接并返回到以前研究过的 URL。
🔄 比较和恢复:比较版本显示历史快照之间的变化,包括文本、元数据、标题、链接、字数、价格和内容相似性。
视觉比较提供并排屏幕截图、叠加和像素级差异。
恢复页面搜索可用档案以查找已删除、已更改或不可用网页的剩余副本。专业用户可以检查实时状态、识别有用的捕获、提取可读内容并将发现保存到他们的库中。
🔍 历史搜索和更改:在存档网页中搜索单词或短语,并查看它何时出现、消失或更改。
SEO & Changes 显示页面在捕获过程中如何变化:
• 页面标题、描述和规范 URL
• H1/H2 标题和标题计数
• 字数和链接计数
• 内容相似性和变化
• 价格和元数据变化
• 历史摘录
历史趋势显示网站的内容和其他可用指标如何随时间变化。
📚 研究、批量查找和报告
使用研究图书馆整理您的发现,包括 APA、MLA、Chicago、BibTeX 和 Wikipedia 格式的馆藏、注释、标签、档案参考文献和引文。
专业用户还可以:
📦 批量查找 — 调查多达 1,000 个 URL 以了解存档可用性和实时状态。
📊 证据报告 — 创建包含历史捕获、存档链接、更改摘要、元数据、链接和摘录的可共享报告。
📤 导出研究 — 将可用研究导出为 CSV、JSON、Markdown 或 HTML。
🆓 免费和专业版
免费:查找并打开存档网页、搜索多个网络存档、浏览时间线和域历史记录以及按日期检查快照。
专业版:高级和视觉比较、页面恢复、批量查找、历史内容搜索、趋势、研究库、证据报告和导出。
🔒 私密设计
仅当您打开当前选项卡 (activeTab) 时,扩展程序才会读取当前选项卡的地址。它永远不会读取您访问的页面内容 - 除了当您在批量查找中单击“此页面上的链接”时页面上的链接列表之外 - 永远不会跟踪您,并且不包含任何分析。
存档查找通过我们自己的 API(位于 webinternetarchive.com)进行,该 API 会缓存公共存档数据,并且从不存储您访问的页面。登录是可选的(Google),并且仅 Pro 需要。
Web Archive Viewer 与独立的公共网络存档服务合作,不隶属于互联网档案馆或任何其他存档服务,也不由其认可或制作。
🌐 网站:https://webinternetarchive.com/
💬 支持:https://webinternetarchive.com/contact